
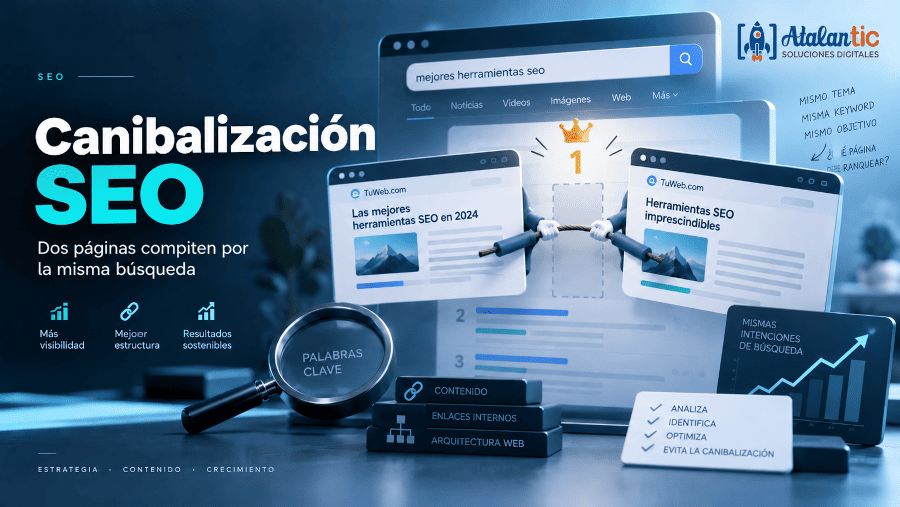
La canibalización SEO aparece cuando varias páginas de una misma web compiten por una intención de búsqueda que debería estar claramente asociada a una URL. Esto puede provocar que Google alterne entre diferentes páginas, termine mostrando una URL secundaria o reparta señales entre contenidos que deberían reforzar una única página. Sin embargo, que dos URLs aparezcan para una misma palabra clave no significa automáticamente que exista un problema: la clave está en saber si ambas intentan responder a la misma necesidad.
Por eso, detectar una canibalización no consiste en localizar keywords repetidas y empezar a eliminar contenidos. Hay que entender qué función cumple cada página, cuál debería ser la principal y si la estructura de la web está enviando señales suficientemente claras a Google.
Qué es realmente la canibalización SEO
La definición más habitual relaciona la canibalización con varias páginas posicionando por una misma palabra clave. El problema es que una web puede tener diferentes URLs apareciendo para consultas similares sin que exista ningún conflicto entre ellas.
Las páginas de una web no se posicionan únicamente para una keyword concreta. Cada URL puede aparecer para muchas búsquedas relacionadas, variaciones semánticas y términos long tail. Por eso, compartir palabras clave no es suficiente para hablar de canibalización.
El problema aparece cuando distintas páginas tienen un nivel de solapamiento tan alto que compiten por la misma intención. En ese escenario, Google recibe varias señales parecidas y tiene que decidir cuál considera más adecuada, aunque nosotros hayamos creado una de ellas con la intención de que fuera la principal.
La diferencia puede parecer pequeña, pero cambia por completo el análisis. La canibalización no consiste en repetir palabras, sino en duplicar funciones dentro de la arquitectura de la web.
Por qué una web acaba compitiendo contra sí misma
La canibalización suele aparecer a medida que una web crece. Se crean nuevos servicios, se publican artículos, aparecen nuevas categorías y se detectan nuevas oportunidades de posicionamiento. Si cada nuevo contenido se plantea de forma independiente, llega un momento en el que distintas URLs empiezan a cubrir territorios demasiado parecidos.
Uno de los motivos más habituales es interpretar el keyword research como una lista de páginas que hay que crear. Encontrar varias keywords relacionadas no significa que necesitemos una URL específica para cada una. Muchas veces se trata simplemente de diferentes maneras de expresar una misma intención.
También ocurre cuando se publican nuevos contenidos sin revisar lo que ya existe. Un blog con varios años de recorrido puede acabar acumulando artículos que abordan un mismo tema desde enfoques apenas distintos. Cada pieza puede haberse creado con sentido en su momento, pero el conjunto termina generando solapamientos que no estaban previstos.
En una tienda online, la situación puede ser todavía más compleja porque intervienen categorías, subcategorías, etiquetas, filtros, productos y páginas generadas automáticamente. En estos proyectos, la canibalización puede estar relacionada tanto con los contenidos como con la arquitectura y el SEO técnico.
Cómo detectar una canibalización SEO
Google Search Console es uno de los mejores puntos de partida porque permite comprobar qué páginas aparecen para una consulta determinada. Si una búsqueda importante está generando impresiones para varias URLs, merece la pena analizar qué está ocurriendo.
No debemos quedarnos únicamente con el número de páginas. Hay que observar su evolución y entender qué papel cumple cada una. Si una URL domina claramente y otras aparecen de manera puntual para determinadas variantes, puede no existir ningún problema. En cambio, si varias páginas muy similares se alternan constantemente o una URL secundaria está ocupando el espacio de la página que debería ser principal, sí tenemos motivos para investigar.
También conviene analizar qué consultas genera cada URL. Dos páginas pueden compartir algunas palabras clave y, al mismo tiempo, posicionarse principalmente para búsquedas diferentes. Ese dato es mucho más importante que detectar una coincidencia aislada.
Herramientas como Semrush pueden facilitar la identificación de keywords asociadas a varias URLs, mientras que Screaming Frog permite revisar elementos como títulos, encabezados, enlaces internos, etiquetas canonical y estructura. Son útiles para detectar patrones, pero la herramienta señala el posible conflicto; el análisis determina si realmente existe.
Que varias páginas aparezcan para la misma keyword no siempre es un problema
No deberíamos intentar construir una web en la que cada palabra clave pertenezca exclusivamente a una URL. El comportamiento de búsqueda es demasiado amplio y variable para funcionar de esa manera.
Dos páginas relacionadas pueden compartir consultas y seguir cumpliendo funciones claramente diferentes. Una puede responder a una intención informativa y otra a una intención comercial. También pueden cubrir distintas fases de una decisión de compra o diferentes niveles de profundidad dentro de un mismo tema.
La cuestión importante es si Google puede entender por qué existen ambas páginas. Cuando cada una tiene un propósito definido, un contenido claramente diferenciado y un enlazado interno coherente, compartir determinadas keywords no debería preocuparnos.
Qué problemas puede provocar la canibalización SEO
La canibalización no es una penalización de Google. No existe una sanción automática por tener varias páginas relacionadas ni una pérdida de posiciones simplemente porque dos contenidos compartan palabras clave.
El problema está en la dispersión de señales.
Una URL puede recibir parte de los enlaces internos, otra acumular enlaces externos y una tercera ser la que realmente queremos posicionar. Si todas están asociadas a un mismo tema, estamos repartiendo recursos que podrían estar reforzando una página principal.
El enlazado interno tiene especial importancia. Si utilizamos anchors similares para enlazar a distintas URLs con una función parecida, estamos dificultando que exista una jerarquía clara dentro del sitio. No se trata solo de decirle a Google de qué habla cada página, sino también de indicarle cuáles son las más importantes dentro de cada área temática.
Otra consecuencia es que termine posicionando una URL que no es la más adecuada para el usuario o para el objetivo del negocio. Podemos seguir teniendo tráfico orgánico y, aun así, estar enviándolo hacia un contenido informativo cuando nos interesaría mostrar una página de servicio, una categoría o una ficha específica.
En sitios muy grandes también puede haber implicaciones de rastreo e indexación cuando se generan grandes cantidades de URLs similares. Aquí pueden entrar conceptos como el presupuesto de rastreo, aunque su importancia depende del tamaño y la complejidad del proyecto y no debería utilizarse como explicación genérica para cualquier caso de canibalización.
Cómo solucionar una canibalización SEO sin cargarte lo que ya funciona
No existe una única solución para todos los casos. Antes de modificar una URL hay que analizar su tráfico, las palabras clave para las que aparece, los enlaces que recibe, su histórico y su papel dentro de la arquitectura.
Una página que parece secundaria para una keyword concreta puede estar posicionando correctamente para otras búsquedas. Eliminarla o redireccionarla sin revisar esa información puede provocar pérdidas que no tienen ninguna relación con el problema inicial.
La decisión debería partir siempre de una pregunta sencilla: ¿estas páginas deberían seguir existiendo como contenidos independientes?
Unificar cuando varias páginas hacen el mismo trabajo
Si dos contenidos responden a la misma intención y apenas existe una diferencia real entre ellos, consolidarlos suele ser una solución más lógica que seguir intentando posicionar ambos.
En ese caso podemos escoger la URL que tenga mejores condiciones para convertirse en la principal y reunir en ella la información que realmente merece conservarse. No se trata de acumular todos los textos existentes, sino de construir una página más completa y mejor enfocada.
Cuando la otra URL deja de tener una función independiente y existe una correspondencia clara con la página que conservamos, puede tener sentido aplicar una redirección 301.
El objetivo es concentrar señales y eliminar una duplicidad que no aportaba nada al usuario ni a la arquitectura.
Diferenciar cuando ambas páginas son necesarias
Si las dos URLs tienen sentido, entonces el trabajo consiste en hacer más evidente la diferencia entre ellas.
Esto implica revisar la intención, el contenido, los encabezados, las palabras clave secundarias y el enlazado interno. Cada página debe responder con claridad a una necesidad específica y ocupar un lugar reconocible dentro del sitio.
En muchos casos, la solución a una canibalización no pasa por eliminar páginas, sino por especializarlas mejor.
Esta es una de las razones por las que limitarse a cambiar el título SEO o repetir una keyword distinta suele ser insuficiente. Si el contenido y la función siguen siendo prácticamente iguales, el problema continuará existiendo aunque hayamos modificado algunos términos.
Cuándo utilizar canonical, noindex o una redirección
La etiqueta canonical, el noindex y las redirecciones responden a problemas distintos y no deberían utilizarse como soluciones intercambiables.
La canonical sirve para indicar cuál consideramos la versión principal cuando existen páginas duplicadas o muy similares. Puede ser útil en determinadas situaciones técnicas, pero no debería utilizarse como parche para páginas que deberían tener funciones distintas.
El noindex permite mantener una página accesible evitando que aparezca en el índice. Puede ser adecuado para determinadas URLs que necesitamos conservar, pero que no aportan valor como resultado de búsqueda.
La redirección tiene sentido cuando una URL deja de ser necesaria como página independiente y queremos dirigir a usuarios y buscadores hacia otra alternativa equivalente.
La elección depende de qué función queremos que tenga cada página. Primero debemos decidir qué debería ocurrir con la URL y, después, escoger la herramienta técnica adecuada.
Evitar la canibalización empieza antes de publicar
La mejor forma de evitar una buena parte de las canibalizaciones es comprobar qué contenido existe antes de crear una nueva página.
Cuando encontramos una keyword interesante no deberíamos preguntarnos únicamente si tiene búsquedas. También debemos comprobar si alguna URL actual ya responde a esa intención y si podemos mejorarla antes de crear otra.
Esto permite trabajar el keyword research de una forma más estratégica. En lugar de convertir cada término en una página, agrupamos búsquedas según su intención y decidimos qué URL debería ser la referencia para cada conjunto.
Una página puede posicionar para una keyword principal, numerosas variaciones y búsquedas long tail relacionadas. No necesitamos multiplicar URLs para cubrir cada forma de expresar la misma necesidad.
Este enfoque también mejora el enlazado interno y la arquitectura general del sitio, porque cada contenido tiene una función clara y sabemos qué páginas queremos reforzar dentro de cada temática.
Al final, evitar la canibalización SEO no consiste en impedir que dos páginas compartan palabras clave. Consiste en tener claro para qué existe cada URL y qué búsqueda queremos resolver con ella. Cuando esa decisión está bien tomada desde el principio, Google tiene muchas más facilidades para entender la estructura de la web y nosotros muchas menos razones para acabar compitiendo contra nuestro propio contenido.